前段时间我写过一篇文章,记录自己作为一名 PHP 开发者自学 Go 的过程 ↗
那篇更多是学习阶段的整理。这次则是一次完整实践的复盘。
单点知识和系统能力之间始终存在差距。
理解一个概念并不难,但要把多个能力组合起来,形成一个可以长期运行的系统,往往需要真实项目去反复打磨。很多看似基础的东西,只有亲手做过,理解才会真正扎实。
最近我完成了一个小工具:HookExec
一个用 Go 实现的 GitHub Webhook 接收服务,按仓库触发服务器上预先放好的脚本,并内置一个单页管理界面,用于查看项目状态和执行记录。
功能本身并不复杂,AI 也完全可以在较短时间内生成类似的实现。但在实际开发过程中,我更在意的并不是功能本身,而是一些基础层面的设计问题:边界划在哪里,并发怎么收敛,以及出异常的时候系统会退化成什么样子。
这些内容未必新鲜,但当它们被组合到一个完整系统中时,体会是不同的。
项目地址我放在文章末尾,感兴趣可以自行查看下载使用。
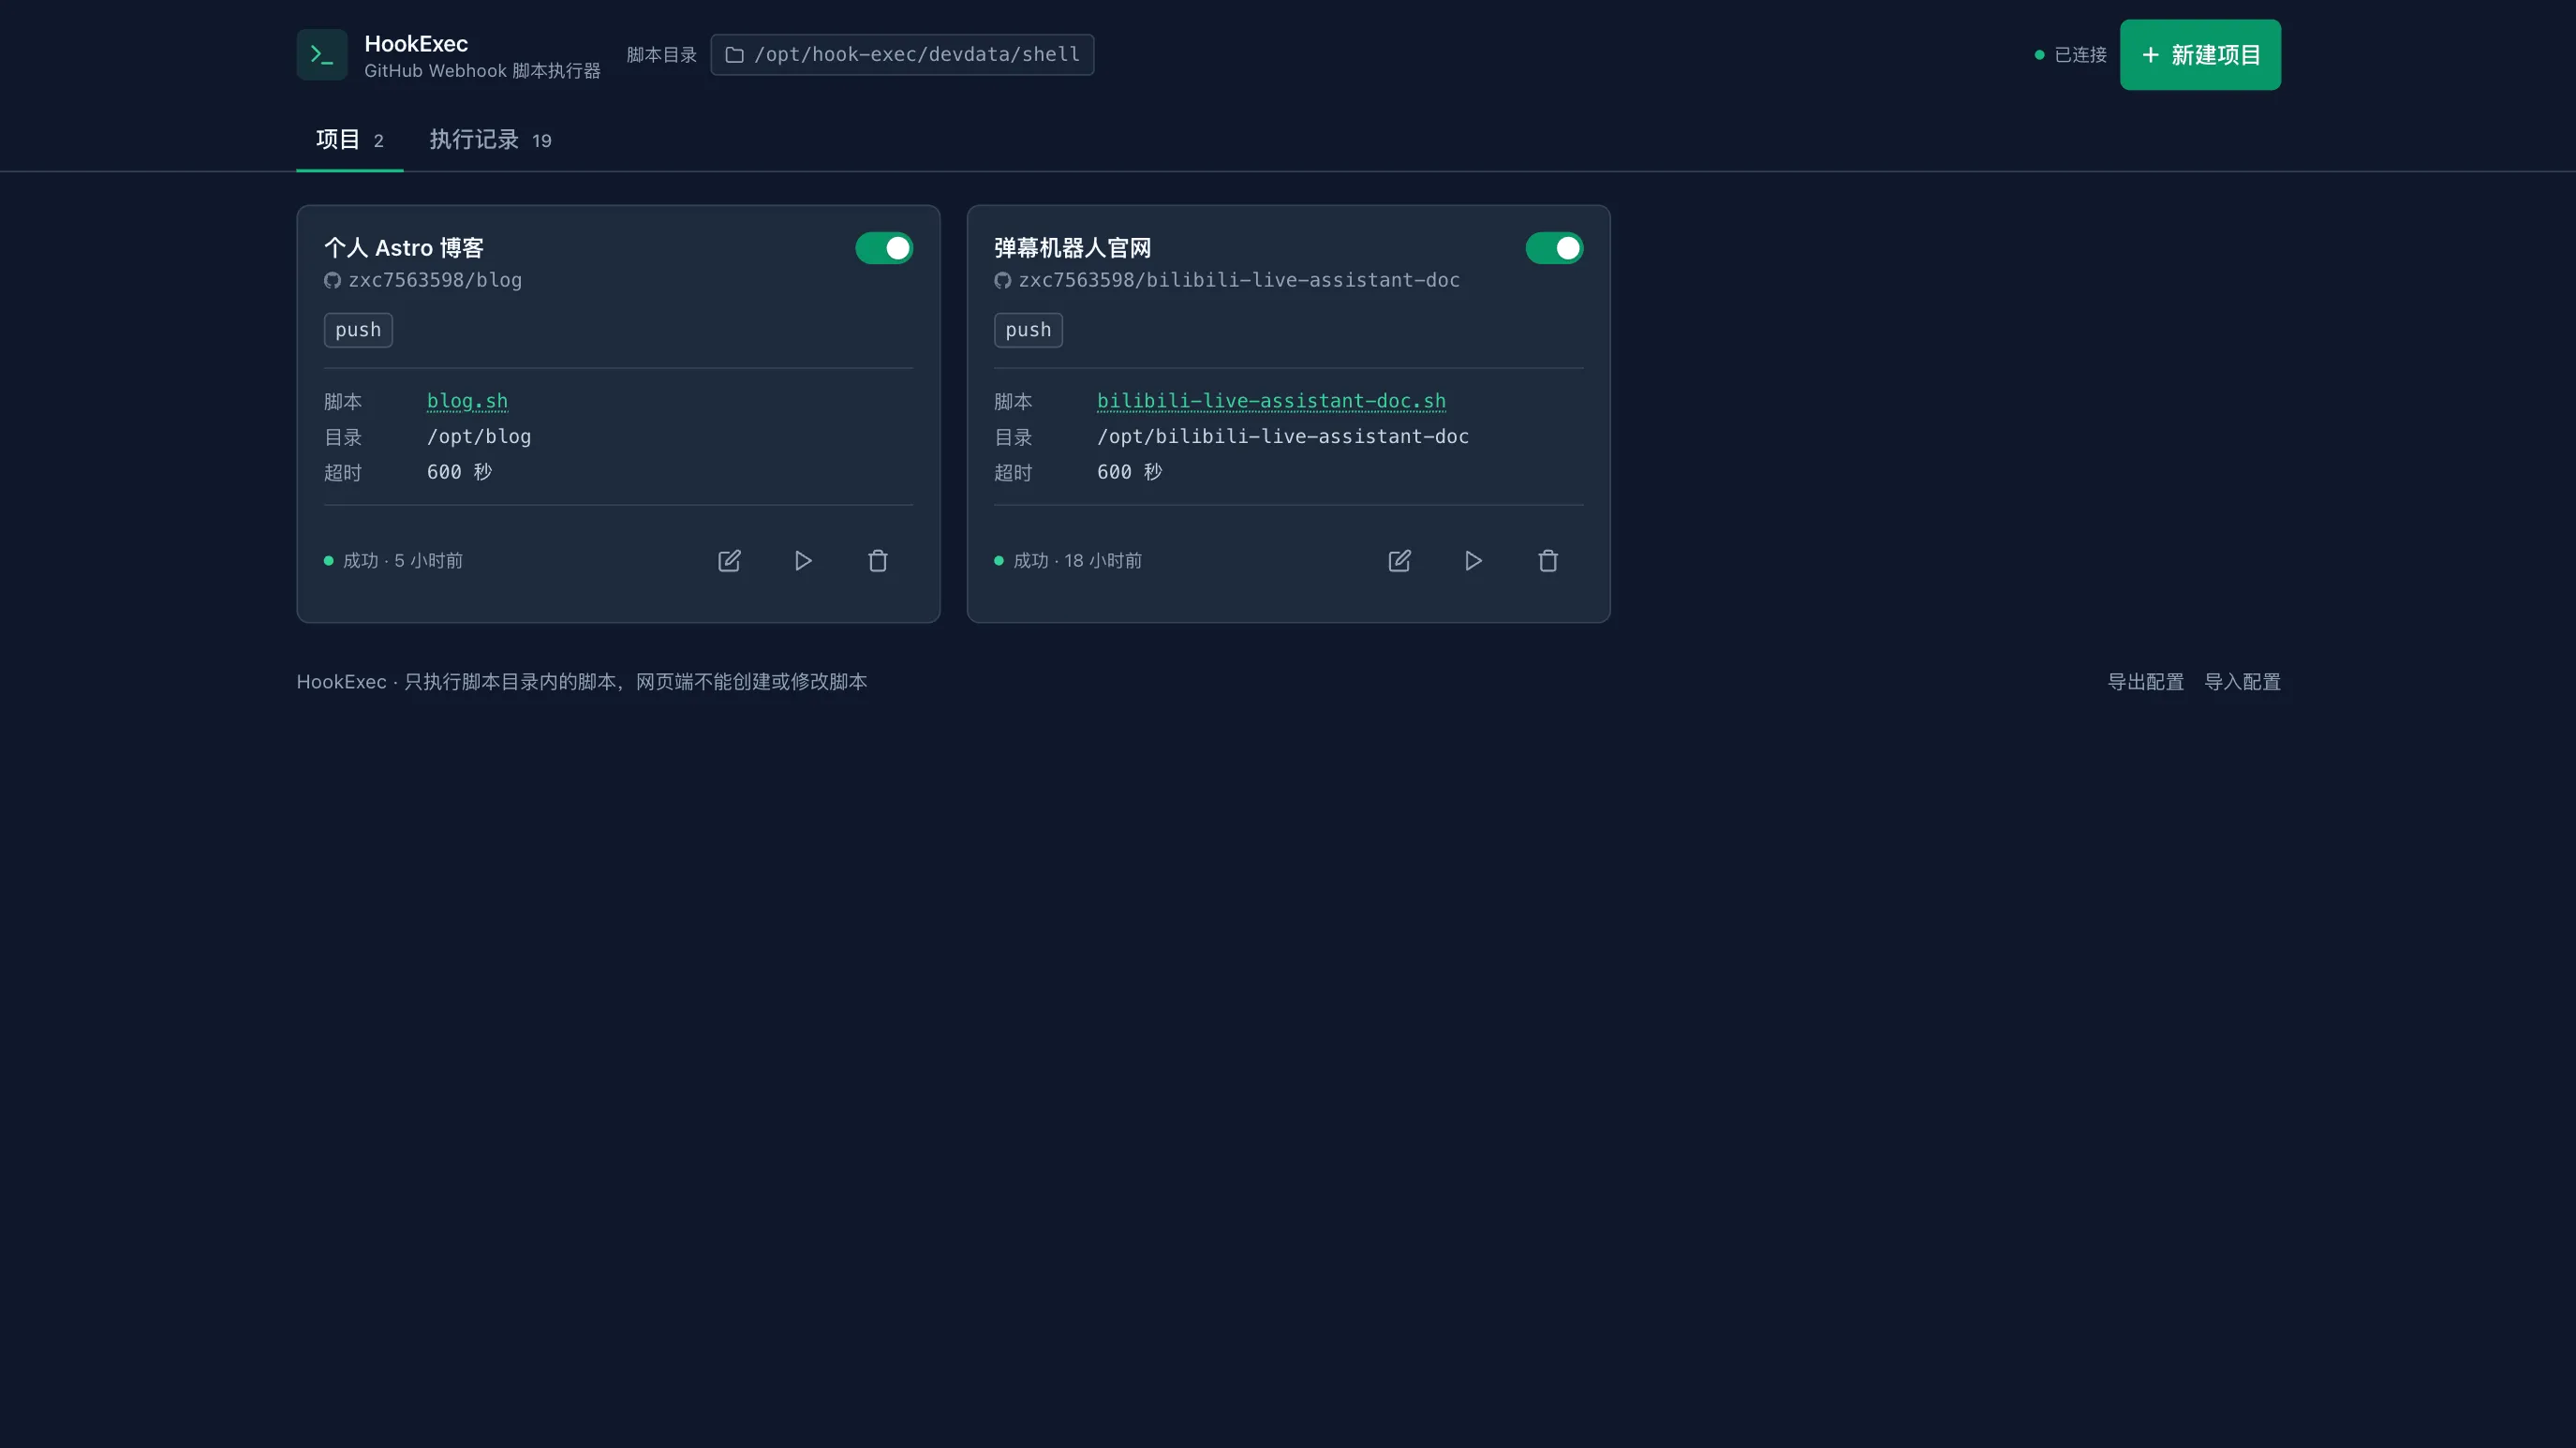
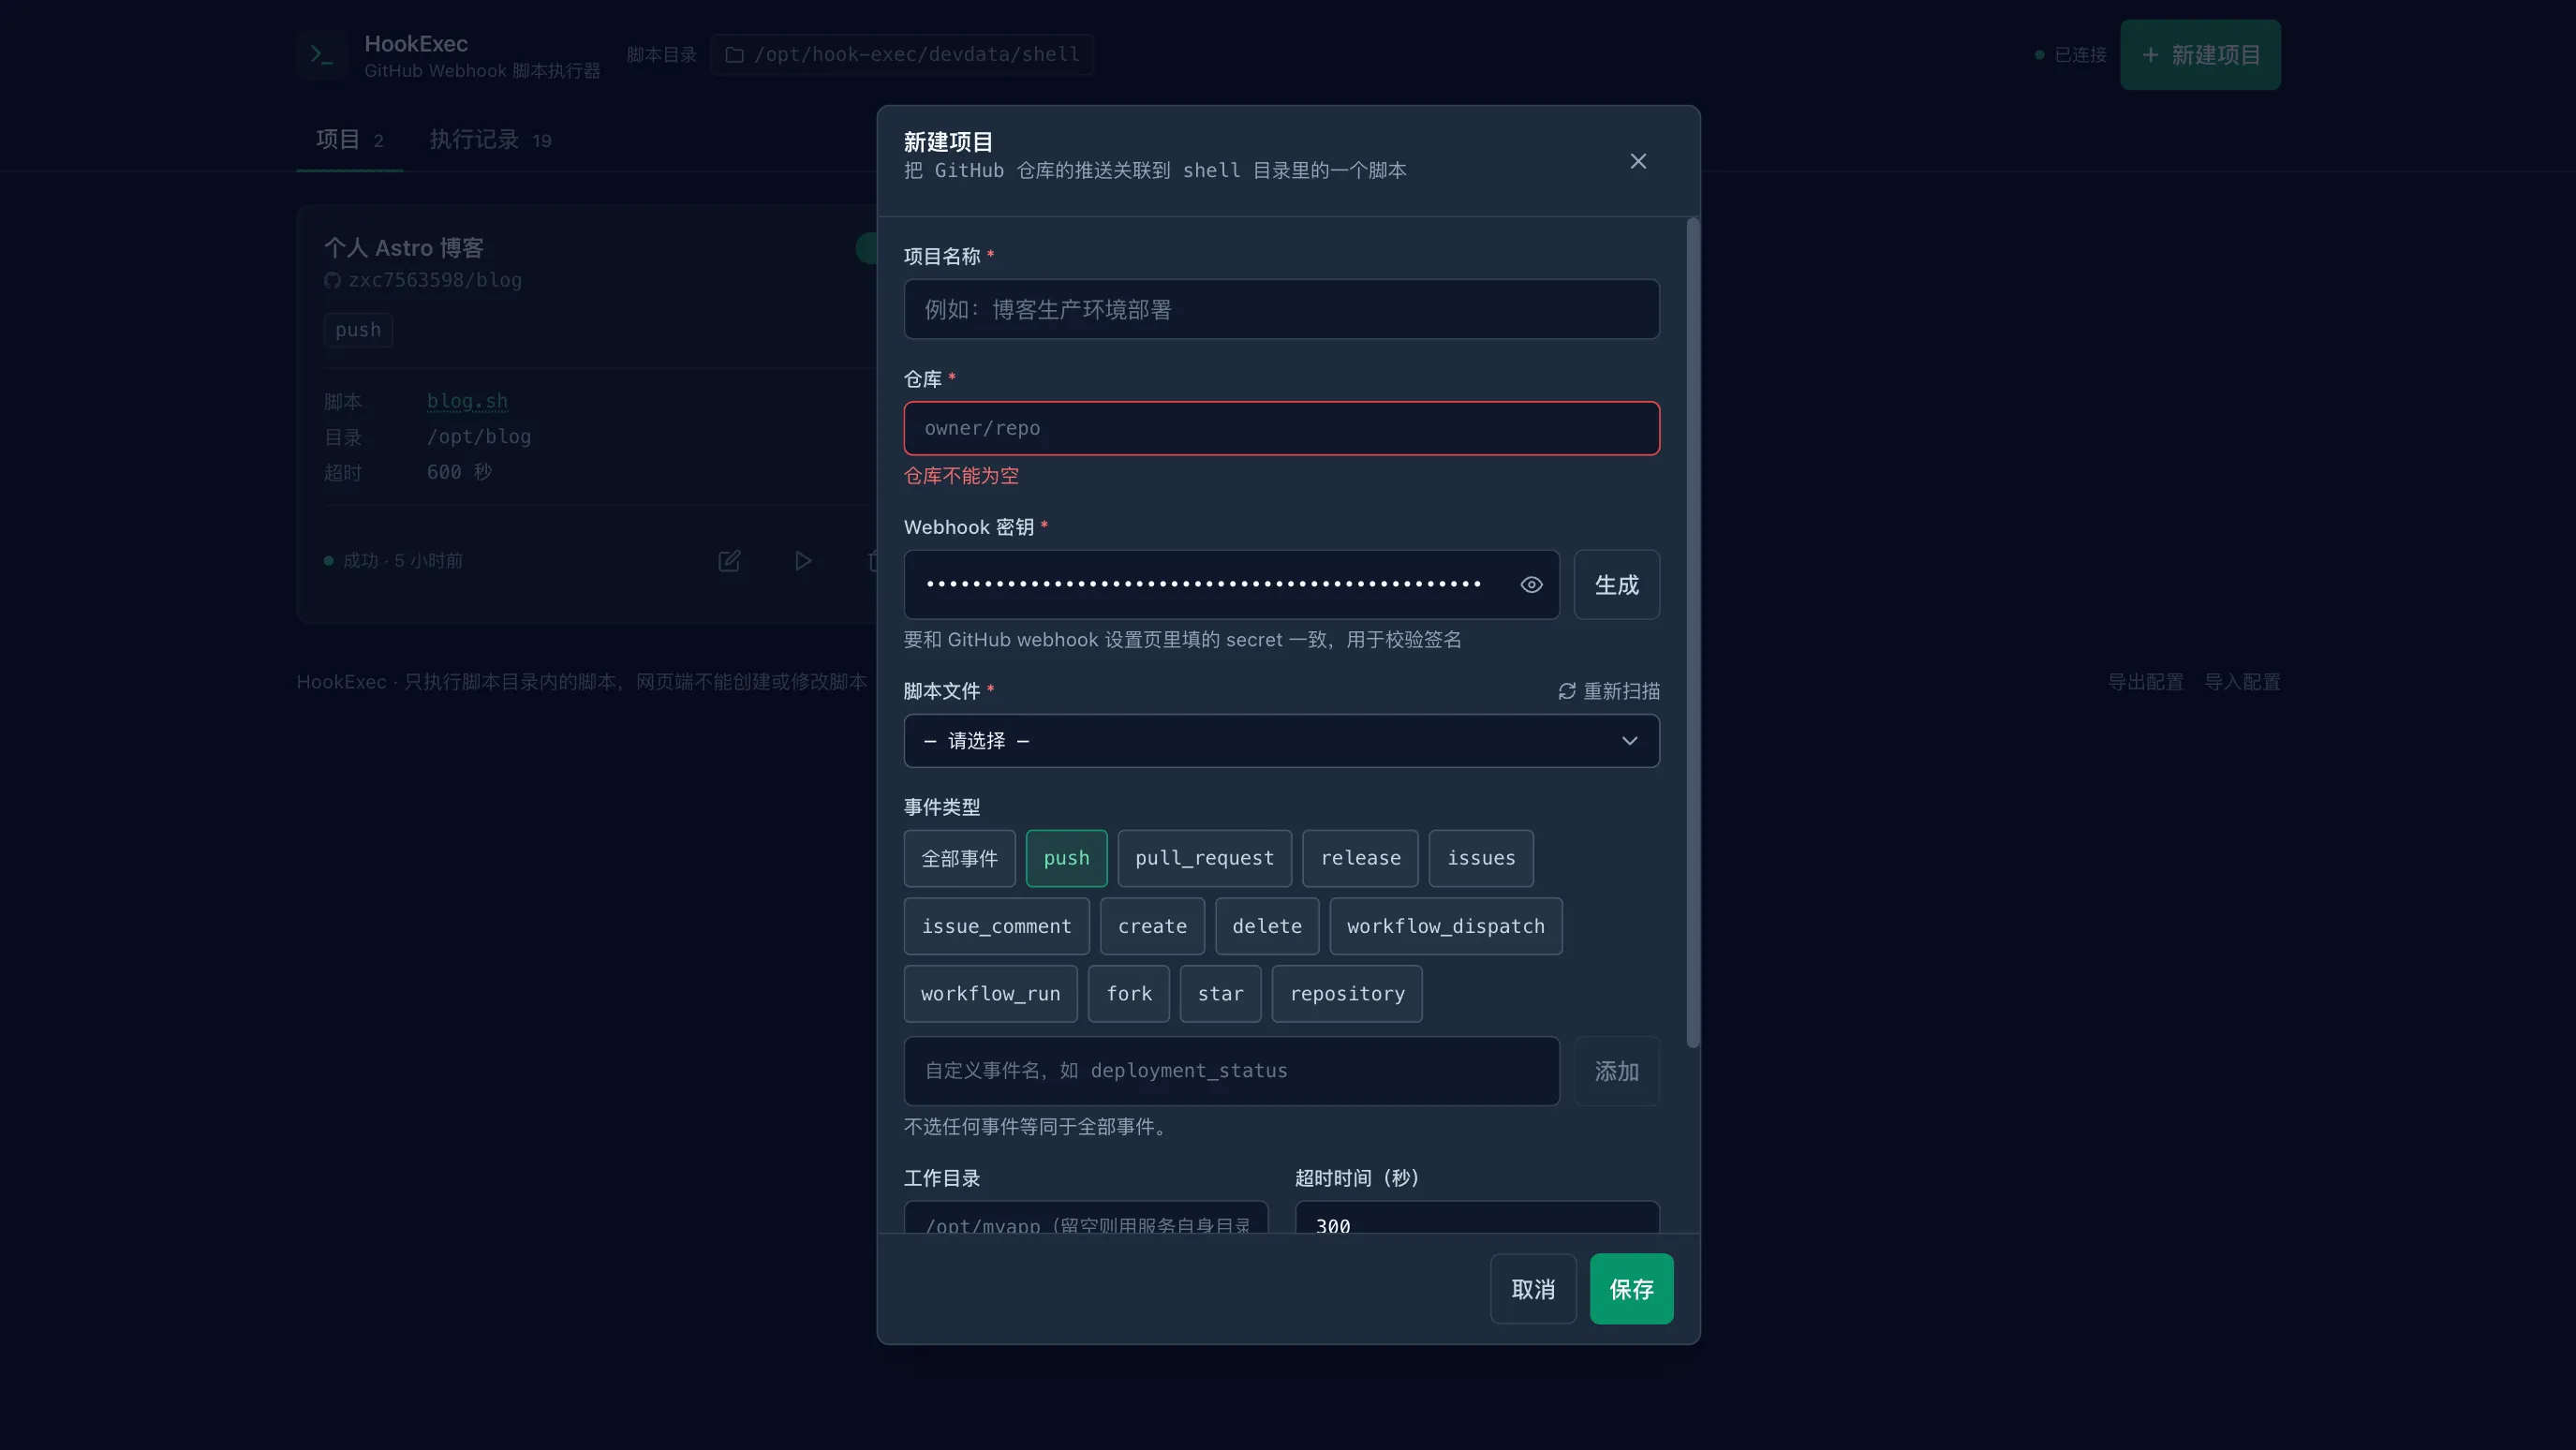
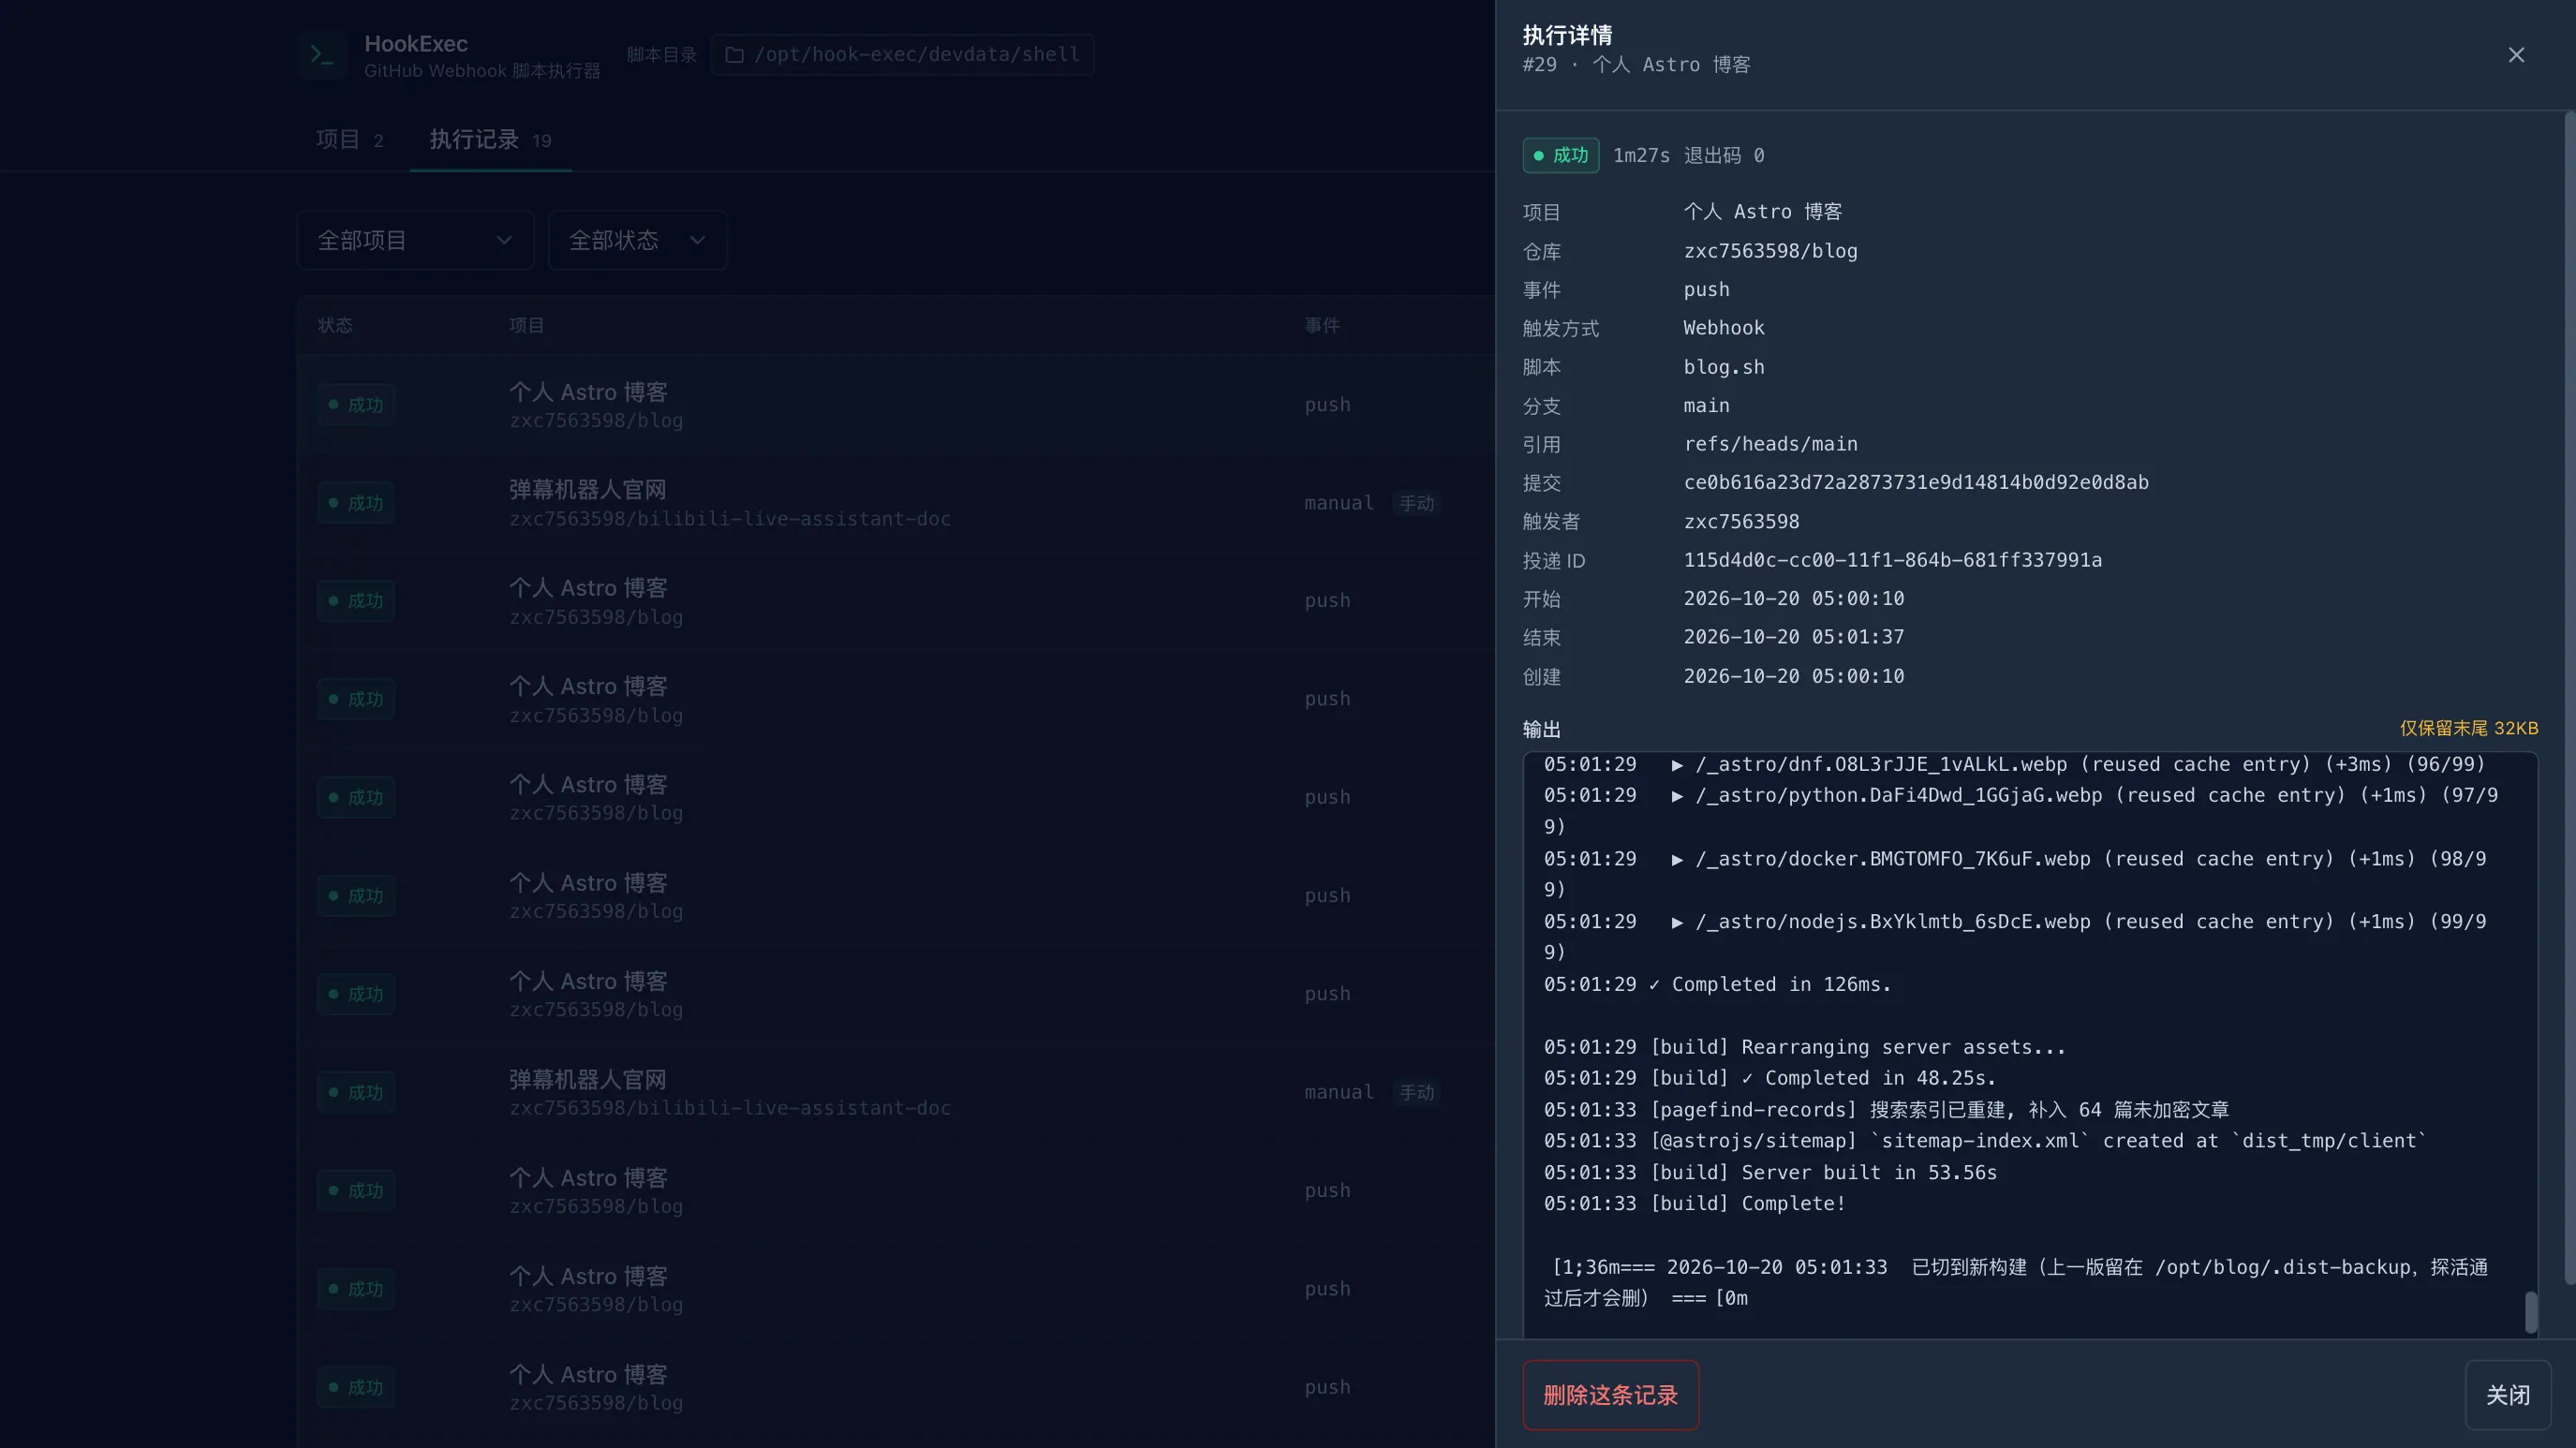
下面我会从结构划分、安全边界、并发模型和交付方式几个方面,做一次相对完整的技术复盘。
项目结构与职责划分#
项目核心代码放在 internal 目录:
internal/
├── config/      启动参数、数据目录定位
├── shelldir/    脚本目录的路径校验
├── model/       实体定义与事件匹配规则
├── store/       SQLite 读写、保留清理、启动对账
├── webhook/     签名校验、payload 解析
├── executor/    并发模型、进程组管理、输出采集
├── api/         管理接口与认证
└── webui/ 单页与内嵌静态资源这种结构并不追求”标准答案”,重点在于依赖方向清晰。
store只负责数据库读写,不含业务判断,不依赖 HTTPshelldir只负责”这个文件能不能执行”,是全部路径判断的唯一出口executor负责调度与执行,依赖store和shelldirwebhook和api是最外层的两个入口,依赖下面这些包,但没有人反过来依赖它们
依赖的组装全部展开在 main.go 里:解析配置、定位数据目录、开库、对账、构造脚本目录、构造执行池、注册路由。没有引入任何 DI 框架,通过显式构造函数完成注入。
项目规模不大时,这种方式反而比自动注入更透明:对象生命周期清晰,依赖方向可控,替换实现时改动也集中在一处。
把安全边界收进一个包#
这是这次做下来我最想说的一点。
服务要执行脚本,那”能执行哪个文件”就是整个系统最关键的一条边界。这条边界如果散落在 handler、service、repository 各处,就永远说不清它到底成不成立。所以我把所有和脚本文件打交道的操作都收进了 shelldir 这一个包,其它地方拿不到脚本目录的路径,只能通过它给的方法去列、去读、去解析。
Resolve 是核心,一个脚本名要过四道校验才会返回可执行路径:
- 形状检查:拒绝空名、绝对路径、
.、.. - 拼成绝对路径后必须落在脚本目录内,挡住
../的各种变体 - 解掉软链之后再判一次落点,挡住
shell/evil.sh -> /etc/passwd这种 - 必须是普通文件,挡住目录、FIFO、设备文件
第三步容易被忽略:前缀比较必须建立在已经 EvalSymlinks 过的路径上,否则路径形态不一致,比较就会失效。macOS 上 /tmp 是 /private/tmp 的软链,这个坑我在本地开发时踩过一次。
更关键的是调用时机。Resolve 在每次执行前重新调用一遍,不缓存、也不相信数据库里存的值:
// 执行前重新解析一次脚本路径。
// 刻意不相信数据库里的值:即使有人直接改库、或者导入了一份恶意配置,
// 也逃不出脚本目录。
scriptPath, err := p.shellDir.Resolve(t.Project.ShellFile)这条决定也约束了产品形态:网页端不提供编写命令的能力。可执行内容只能由运维自己上传到脚本目录,管理页能做的只是从已有文件里挑一个。这样一来,管理页密码泄露的影响面被限制在”能跑服务器上已有的脚本”,而不是”能在服务器上执行任意命令”。
配套的还有一点:命令行里不允许出现任何来自配置或 payload 的字符串拼接。唯一的变量是刚经过校验的脚本路径,脚本需要的信息全部走环境变量和 stdin。这样就不存在把 payload 里的内容拼进命令行的可能性。
并发模型:同项目串行,跨项目并行#
执行池的并发模型是这次改动最大、也是我想得最久的地方。
一开始的想法很自然:一个任务队列,若干个 worker goroutine,谁空了谁去取。但很快发现一个反例——同一个仓库连着推两次,两个部署脚本会同时在服务器上跑:一个在 git reset --hard,另一个在 npm run build,结果就是互相打架。部署脚本本身不是并发安全的,这个保证必须由调度层给。
所以最后的结构是”每个项目一条 lane”:
type lane struct {
    projectID uint
    queue     chan *Task
    quit      chan struct{}
    // ...
}每条 lane 有自己的队列和一个常驻 goroutine,队列里的任务按投递顺序依次执行,天然 FIFO。不同项目的 lane 彼此独立、并行执行,总量由全局信号量兜住(默认 4,--concurrency 可调),免得二十个项目同时触发把机器打满。
还有几个具体的取舍。
单条 lane 的排队上限是 64,超了就把它标成”已跳过”并落一条记录,但 webhook 依然立刻返回 200。原则是绝不让 GitHub 等我们:请求超时它会重投,重投只会让积压更严重。
laneFor 的”查找 + 创建”必须在同一把锁内完成,否则两个并发的 webhook 会各自建一条 lane,同一个项目就有了两条 worker,“同项目串行”这条唯一的保证直接被破坏。
项目被删除时,lane 不从 map 里删掉,只是标记为已停止。如果删掉,一个已经进入处理流程、手里还握着候选项目列表的 webhook 会在 laneFor 里查不到,于是再建一条,同样的问题又回来了。留着这条 stopped 的 lane,后续投递会直接返回”项目已被移除”。项目 ID 是自增的,不存在复用,所以不需要考虑重新启用同一条 lane。
停机时的在途计数用的是 sync.Cond 而不是 WaitGroup。因为 Submit 需要把”检查未停机”和”计数 +1”原子完成,两者必须用同一把锁保护;而 WaitGroup 的 Add 与 Wait 并发调用会 panic。
p.stateMu.Lock()
if p.draining {
    p.stateMu.Unlock()
    return ErrDraining
}
p.inflight++
l := p.laneFor(t.Project.ID)
p.stateMu.Unlock()这段临界区里连 laneFor 一起做掉了。看起来有点重,但如果不这样,停机流程在等待超时后调用 wg.Wait() 的同时,一个刚通过 draining 检查的 Submit 可能才走到 wg.Add——既违反 WaitGroup 的约束,新建的 lane 也不在停机快照里,它的 quit 永远不会被 close,worker 永久阻塞,进程退不掉。
超时不是杀个壳:进程组管理#
exec.CommandContext 的默认超时行为,只杀目标进程本身。而我们执行的是部署脚本,它下面会派生 npm run build、后台起的服务……超时杀掉顶层进程之后,这些子进程会变成孤儿继续跑,服务器上的状态反而更糟。
所以必须把整个进程组一起收掉:
cmd.SysProcAttr = &syscall.SysProcAttr{Setpgid: true}
cmd.Cancel = func() error {
    return terminateGroup(cmd.Process.Pid, exited, tb)
}Setpgid 让子进程自成进程组,终止时对 -pid 发信号就能覆盖整组。顺序是先 SIGTERM,给脚本一个 trap 收尾的机会,宽限 3 秒后还在跑才 SIGKILL。
这里有个细节值得单独说:判断”进程是否已经退出”用的是 channel,不是 cmd.ProcessState。
exited := make(chan struct{})
runErr := cmd.Run()
close(exited)原因有两个。一是 ProcessState 由 Wait 在另一个 goroutine 里写,裸读它是数据竞态。二是从 wait4 返回到内核真正回收 pid 之间存在一个窗口,一旦 pid 被复用,补发的那发 SIGKILL 就会打到无关的进程组上。用 channel 之后,补刀的定时器只会在进程确实还活着的时候才走到 SIGKILL。
另外两个相关设置:
cmd.WaitDelay设为 5 秒。脚本如果把 stdout 管道传给了没退出的孙进程,没有这个上限,Wait会一直挂住。- 执行状态的判定以
ctx.Err()为准,而不是比较cmd.Wait()的返回值。因为我们用了自定义的Cancel,Wait的错误不再保证是context.DeadlineExceeded;如果直接拿它做相等比较,超时就会被一律记成”失败”,“超时”这个信号就丢了。
switch {
case errors.Is(ctx.Err(), context.DeadlineExceeded):
    return model.StatusTimeout, "执行超时,进程组已被终止"
case errors.Is(ctx.Err(), context.Canceled):
    return model.StatusInterrupted, "服务停机,执行被中断"
case runErr == nil:
    return model.StatusSuccess, ""
}输出采集用的是一个只保留末尾 32KB 的滑动缓冲。不用 bytes.Buffer 是因为它没有上限,不用 bufio.Scanner 是因为它有 64KB 的行长上限、遇到超长单行会直接报错。保留尾部而不是头部,是因为脚本失败时最有用的信息通常就在最后几行。
幂等,以及那些看起来奇怪的状态码#
GitHub 有”Redeliver”功能,手动重投会重复投递同一个 delivery。如果每次都执行,部署脚本就会跑两遍。
幂等靠数据库的唯一约束实现,而不是内存里做去重:executions 表在 (delivery_id, project_id) 上建了唯一索引,插入时用 ON CONFLICT DO NOTHING,冲突就说明这次投递处理过了,直接回 duplicated,不执行。
这里有个看起来多余、实际很重要的处理:X-GitHub-Delivery 头缺失时要合成一个。
GitHub 一定会带这个头,但中间的反代、SIEM 或者自建客户端可能把它剥掉。那样所有请求的 delivery_id 都是空串,第二个 webhook 就会撞上唯一约束,被静默判成”重复投递”而根本不执行。对部署脚本来说这是最糟糕的失败方式——什么都没发生,还看不出来。所以缺失时合成一个并记一条 warn 日志。
响应码的设计也是反复权衡过的:
- 正常触发、重复投递、队列满,一律
200。GitHub 只在非 2xx 时标红并重投,而这些情况重投都不会让事情变好。 - 事件不匹配(比如给一个只配了
push的仓库推了issue_comment)回200,而且不产生执行记录,否则记录表会被噪音塞满。 - 服务正在停机时回
503,明确告诉 GitHub 稍后再来,而不是收下却丢掉。 - “仓库没配过”、“配了但停用”、“签名不对”这三种情况,返回完全一样的
401
最后一条单独解释一下。如果”仓库没配过”回 200 而”签名不对”回 401,那么一个不需要任何凭证的请求,就能靠状态码判断出某个仓库在这台服务器上配了没有,等于把配置信息白白枚举出去。三种情况响应完全一致,就什么都问不出来。代价是给一个还没配置的仓库加 webhook 时,GitHub 那边会标红,但这其实也是有用的提示,具体原因会写在服务端日志里。
同样的思路还体现在验签循环上:一个仓库下可能配了多个项目、各自有不同的 secret,校验时要遍历全部候选项目,不能验到第一个就返回。提前返回会让响应耗时随”匹配到第几个项目”变化,等于用时间侧信道泄露了哪个 secret 是对的。
另外,请求体读之前用 MaxBytesReader 限制了 5MB。GitHub 自己的上限是 25MB,但普通 push 只有几 KB,5MB 足够应付带大量 commits 的推送,同时挡住了”拿超大 body 打爆内存”这种最省事的攻击。
Makefile 与单文件交付#
项目使用 Makefile 统一管理构建入口:编译、前端样式、交叉编译、发布打包。
Makefile 在这里的意义并不是”少打几行命令”,而是把所有构建流程显式记录下来,新环境下可以直接复现,发布步骤也标准化了。make release 会做两件额外的事:版本号取自 HEAD 上的 tag(没有 tag 或工作区有未提交改动就直接拒绝,免得打出一个对不上任何一次提交的包),以及一次性打出四个平台的包和一份 checksums.txt。
交叉编译靠 CGO_ENABLED=0:SQLite 走的是纯 Go 实现(glebarez/sqlite,底层 modernc.org/sqlite),不需要目标平台的工具链,一台机器就能打出全部产物。
前端这边,管理页是一个单文件的 Vue 3 + Tailwind 页面,没有构建步骤。Vue 和预编译好的 CSS 都放在 internal/webui/vendor/ 下,随二进制一起分发:
//go:embed index.html vendor/*
var files embed.FS部署机器不需要 Node.js,也不依赖任何外网 CDN。这一点在内网环境里尤其重要。挂个 CDN 只会让页面变白,锁定版本也避免了”CDN 上更新了大版本导致页面行为变了”这种没法复现的问题。
最终效果是:只有一个可执行文件,不需要运行时环境,不需要单独部署前端,不依赖外部静态文件目录。分发成本几乎为零。
Go 在这一点上确实有明显优势:编译后就是完整产物,不依赖包管理器,不依赖额外解释器。
写在最后#
这个项目没有刻意追求复杂设计,也没有引入额外框架。
它更像是一次完整的工程实践:把分层、边界划分、并发控制、异常处理这些已经学过的能力组合在一起,形成一个可以长期运行的系统。写完之后回头看,真正花时间的都不是功能本身,而是那些”出问题的时候会怎样”的地方。超时之后进程有没有被收干净,重复投递会不会执行两遍,管理页密码泄露之后最坏能坏到什么程度,这些都得在写代码的时候就想到。
我自己已经在实际环境中持续使用它,用来自动化部署和执行脚本,稳定性和可维护性都符合预期。对我来说,它已经从”练手项目”变成了日常工具。
如果你刚好也需要一个简单的 GitHub Webhook 执行工具,可以直接拿去用;
如果你正在学习 Go,想找一个结构完整、但复杂度可控的小项目作为参考,也可以看看实现细节。
GitHub 仓库地址:点击查看 ↗
有问题或者想法,也欢迎直接在 GitHub 上交流。